Données et tableaux croisés
Nominal : des catégories sans ordre
- Une variable nominale classe les observations dans des catégories mutuellement exclusives, sans ordre entre elles.
- Aucune opération arithmétique n’a de sens.
- Dans le domaine international :
- le type de régime.
- le continent.
- l’issue d’une guerre : victoire, traité, trêve.
- le type de mission de maintien de la paix.
- Son seul résumé est le mode, la catégorie la plus fréquente : l’Afrique, 52 pays sur 169.
- Les catégories sont rangées par ordre alphabétique, une commodité d’affichage : on pourrait les permuter sans rien changer. Aucune n’est plus grande ou plus petite qu’une autre.
Ordinal : des catégories ordonnées
- Une variable ordinale classe les observations dans des catégories ordonnées : une valeur est plus grande, plus importante ou meilleure qu’une autre.
- Les distances entre catégories ne sont pas mesurables.
- Dans le domaine international :
- le niveau d’hostilité d’un différend militarisé, de la menace à la guerre.
- le score Polity, de −10 à +10.
- le statut Freedom House : libre, partiellement libre, non libre.
- l’intensité d’un conflit armé selon l’UCDP : mineur ou guerre, au seuil de 1 000 morts.
- l’indice de démocratie V-Dem découpé en trois niveaux,
democratie3(tutorat 2).
- Pour
democratie3, l’ordre des catégories a un sens et les pourcentages cumulés deviennent lisibles : 58.0% des pays ont une démocratie faible ou moyenne. - Le mode et la médiane ont un sens, ici « forte » et « moyenne » : la médiane se lit dans le tableau de fréquences, à la catégorie où le pourcentage cumulé atteint 50. La moyenne, non.
Intervalle et ratio : des variables numériques
- Intervalle : la distance entre les valeurs est quantifiable, les intervalles sont égaux, un écart d’une unité vaut la même chose en tout point de l’échelle. Mais le zéro est arbitraire : il n’indique pas l’absence de la caractéristique mesurée. Les rapports (×2, ÷2) n’ont pas de sens métrique. Ex. : l’année, un score standardisé, la température en degrés Celsius.
- Ratio : les mêmes propriétés, avec en plus un zéro absolu, qui indique l’absence de la caractéristique mesurée. Les rapports (×2, ÷2) ont un sens métrique : un PIB par habitant de 20 000 dollars est le double d’un PIB de 10 000. Ex. : l’âge, le PIB par habitant, les morts au combat, le montant de l’aide.
- Un tableau de fréquences n’est pas approprié : on résume la distribution par son minimum, son maximum, sa médiane, ses quartiles, sa moyenne et son écart-type, ou on recode la variable en catégories (tutorat 2).
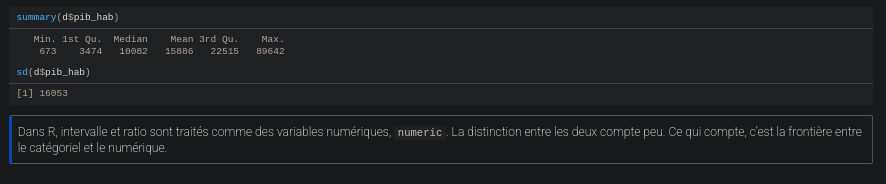
Quelle statistique selon le niveau de mesure ?
Pourquoi le niveau de mesure est-il important ?
- Le niveau de mesure définit les propriétés des variables, ordre, intervalles, zéro absolu, et détermine quelles opérations statistiques sont valides.
- Conséquences analytiques :
- représentation graphique appropriée : diagramme en barres, histogramme, boîte à moustaches.
- statistiques descriptives appropriées : mode, médiane, moyenne.
- tests statistiques compatibles avec les hypothèses de mesure.
- mesures d’association cohérentes avec la structure des données : V de Cramér, r de Pearson.
- modèles de régression appropriés : régression linéaire, logistique.
- Appliquer un outil incompatible avec les propriétés de mesure compromet la validité des inférences.
- Mais le traitement reste un choix :
- une échelle ordinale est souvent traitée comme numérique, à des conditions précisées à la diapositive suivante.
- le niveau de mesure est une propriété de la variable. Le traitement statistique est un choix de l’analyste, à justifier.
Traiter une variable ordinale comme numérique : à quelles conditions ?
- Le débat porte sur la validité de l’inférence quand des variables ordinales sont analysées comme des variables numériques (Harpe 2015, 842; Norman 2010, 625).
- En pratique, on peut les traiter comme numériques si certaines conditions sont réunies :
- au moins cinq catégories effectivement utilisées.
- une distribution sans asymétrie marquée, sans effet plancher ni plafond, c’est-à-dire sans concentration des observations sur la valeur minimale ou maximale.
- un n raisonnable et des groupes de tailles comparables si l’on compare des groupes.
- des méthodes robustes, moins sensibles aux écarts aux hypothèses : ANOVA de Welch, erreurs-types groupées.
- Dans le cours : Polity, de −10 à +10, combinaison pondérée de composantes ordinales, est le cas typique. Souvent traité comme numérique, il bute sur son plafond, 34 pays sur 161 à +10 en 2015 : le tutorat 2 le recode en trois catégories.
Le cadre de l’analyse bivariée
Analyser deux variables : quatre questions
- Association :
- existe-t-il une relation entre les deux variables, ou sont-elles indépendantes ?
- Force de la relation :
- quelle est son intensité ? C’est la taille de l’effet.
- Direction :
- la relation est-elle positive ou négative ?
- Inférence :
- peut-on généraliser cette relation à la population ?
- quand les données sont la population entière, l’écart observé dépasse-t-il ce que le hasard seul produirait ?
- tests, valeurs p, intervalles de confiance.
Variable indépendante, variable dépendante
- Quand la relation est asymétrique, orientée par l’hypothèse, on distingue la variable indépendante (VI), explicative, et la variable dépendante (VD), à expliquer. Variable indépendante (VI) → Variable dépendante (VD)
- Le choix de la VI dépend de l’hypothèse formulée, pas des données : « les démocraties connaissent moins de conflits » fait du régime la VI et du conflit la VD. Régime politique (VI) → Conflit (VD)
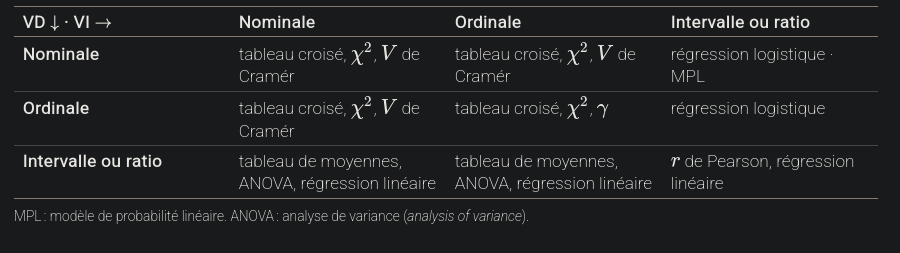
- Le choix de la méthode dépend des niveaux de mesure de la VI et de la VD.
- Les questions de causalité relèvent de l’analyse multivariée : une analyse bivariée décrit une association.
Le niveau de mesure détermine l’outil
Le tableau croisé
Principe et structure
Le tableau croisé, ou tableau de contingence, examine la relation entre deux variables catégorielles, nominales ou ordinales.
Objectif
- Déterminer dans quelle mesure les modalités d’une variable tendent à s’associer avec certaines modalités de l’autre.
Structure
- Chaque case contient l’effectif, c’est-à-dire le nombre d’observations, d’une combinaison de modalités.
- Les marges donnent les totaux par ligne et par colonne.
Le calcul des pourcentages
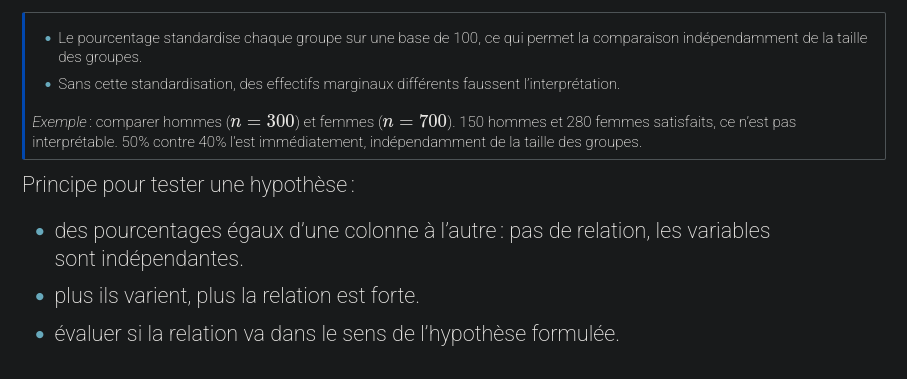
Quand on teste une hypothèse avec un tableau croisé, les pourcentages se calculent dans chaque modalité de la VI :
- si la VI est en colonnes, les pourcentages se calculent en colonne, sur le total de chaque colonne.
- si la VI est en lignes, les pourcentages se calculent en ligne, sur le total de chaque ligne.
Conseil pratique
- Placer la VD en lignes et la VI en colonnes, ce qui facilite la comparaison.
- Le choix de la VI dépend de l’hypothèse formulée.
Pourquoi des pourcentages par modalité de la VI ?
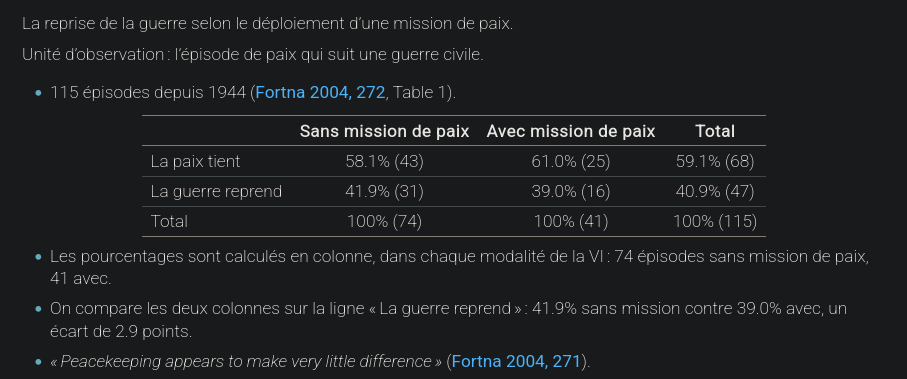
Un premier regard : Fortna (2004)
Comparer les pourcentages : deux mesures
La différence de pourcentages, mesure absolue, en points de pourcentage :
- 41.9 − 39.0 = 2.9 points. Pour 100 épisodes de paix, cela fait 3 reprises de moins avec une mission de paix.
Le rapport de pourcentages, mesure relative :
- 39.0 / 41.9 = 0.93 : avec une mission, le risque de reprise vaut 0.93 fois le risque sans mission, soit 7% de moins en valeur relative, et non 7 points.
Les deux se complètent : la différence dit l’ampleur concrète, le rapport dit le multiplicateur.
- Un même rapport de 2 peut correspondre à 2% contre 1%, une différence de 1 point, ou à 60% contre 30%, une différence de 30 points. Le rapport seul ne dit pas l’ampleur, la différence seule ne dit pas le multiplicateur : il faut donner les deux.
Test de signification : principe général
Les écarts observés dans un tableau peuvent provenir de deux sources :
- une différence réelle entre les groupes.
- le hasard.
Quand les cas sont un échantillon aléatoire, ce hasard est celui du tirage, la variation d’un échantillon à l’autre.
- Un test de signification mesure à quel point l’écart observé serait improbable si le hasard seul jouait.
- Il ne répond qu’à cette question : il ne dit ni d’où vient l’écart ni s’il est important.
Test de signification : le cas de la population entière
Quand les données couvrent tous les cas (Farber et Gowa observent toutes les paires d’États, Fortna les 115 épisodes de paix qui suivent une guerre civile depuis 1944) :
- il n’y a pas d’erreur d’échantillonnage : les pourcentages décrivent exactement ces cas.
- le test pose alors une autre question : en redistribuant les mêmes cas au hasard entre les groupes, obtiendrait-on souvent un écart aussi grand (Blalock 1979, 242; Freedman et Lane 1983, 292) ?
Dans les deux cas, échantillon ou population entière, le test écarte une seule explication de l’écart : le hasard.
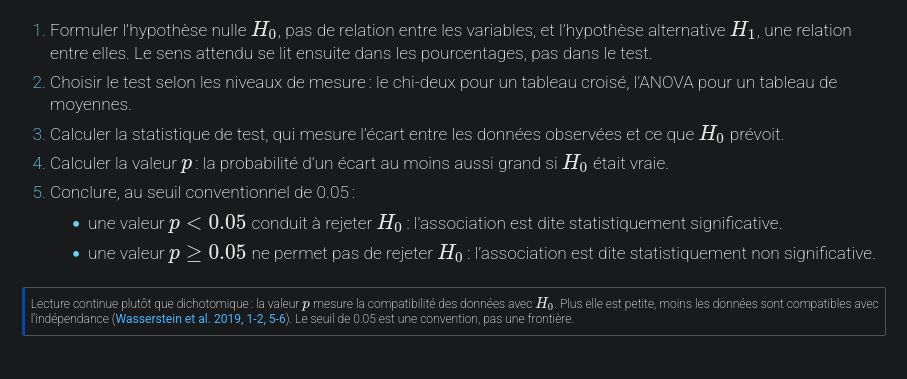
Test de signification : étapes de la démarche
Le test du chi-deux : principe
Le test du chi-deux est un test de signification : il demande si l’écart observé dans le tableau pourrait venir du hasard seul.
- Les hypothèses, chez Fortna :
- H0 : les deux variables sont indépendantes. La reprise de la guerre ne dépend pas de la présence d’une mission de paix.
- H1 : les deux variables ne sont pas indépendantes. Que la paix tienne plus souvent avec une mission, le sens attendu, se lit dans les pourcentages, pas dans le test.
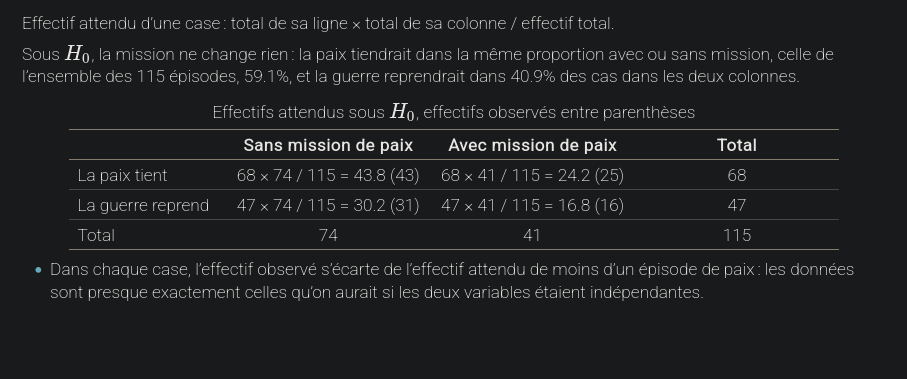
- Le test compare les effectifs observés dans chaque case aux effectifs attendus sous H0, ceux que donneraient les seules marges du tableau :
- très différents : on rejette H0 et l’on conclut à une relation.
- similaires : on ne peut pas rejeter H0.
- Le test est symétrique : il ne distingue pas la VI de la VD.
Les effectifs attendus sous l’hypothèse nulle
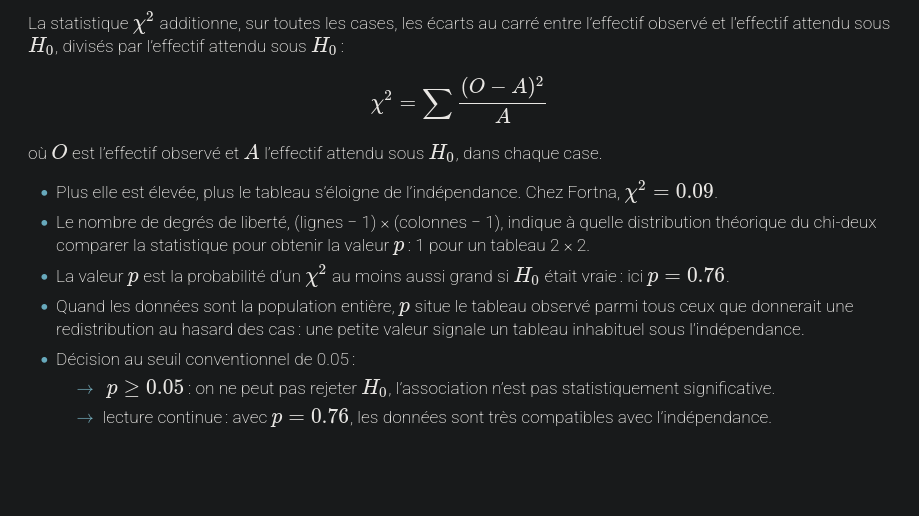
La statistique du chi-deux et la valeur p
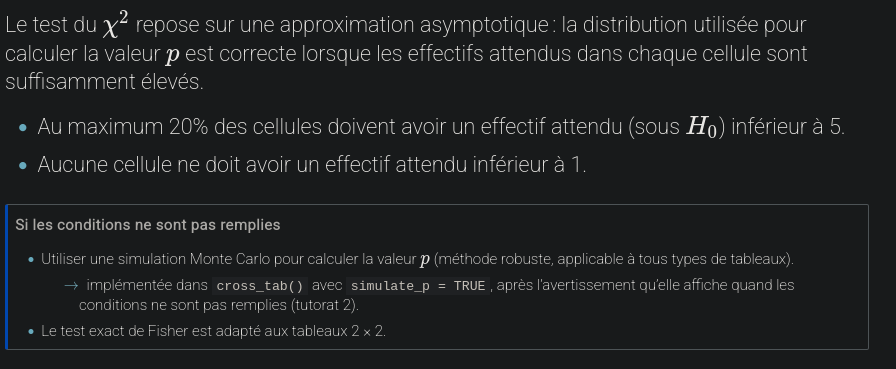
Test du χ2 : conditions d’application
Test du χ2 : limites
- Le résultat dépend du choix des catégories : le nombre de modalités et leur regroupement peuvent modifier la statistique et la valeur p.
- Le test est global : il indique qu’une association existe, sans préciser quelles cellules ou modalités contribuent le plus à cette association.
- Le χ2 ne mesure pas l’intensité de l’association : il faut le compléter par une taille d’effet (p. ex. V de Cramér, φ).
Significativité statistique vs importance substantielle
Un résultat statistiquement significatif (p<0.05) n’implique pas nécessairement une association importante.
- La significativité statistique indique une faible compatibilité avec H0.
- Elle dépend notamment de la taille de l’échantillon (n).
- Avec un grand n, des effets faibles peuvent devenir significatifs. → Il faut compléter la valeur p par une mesure de l’ampleur de l’effet.
Mesurer l’intensité de l’association
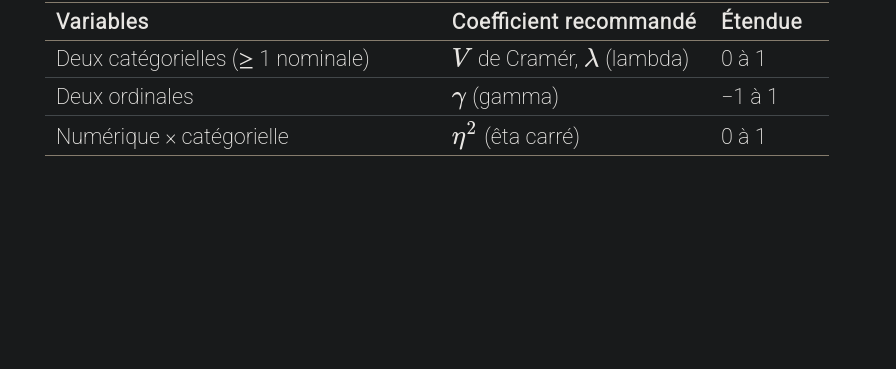
Coefficient d’association : mesure synthétique de l’intensité globale de l’association.
Caractéristiques générales
- Résumés statistiques standardisés qui varient entre :
- 0 et 1 : mesures sans direction (intensité seulement).
- −1 et 1 : mesures avec direction (sens + intensité).
- Plus la valeur est proche de 1 (ou −1), plus l’association est forte.
- Plus la valeur est proche de 0, plus l’association est faible.
Choix du coefficient selon le niveau de mesure
Taille d’effet : idée générale
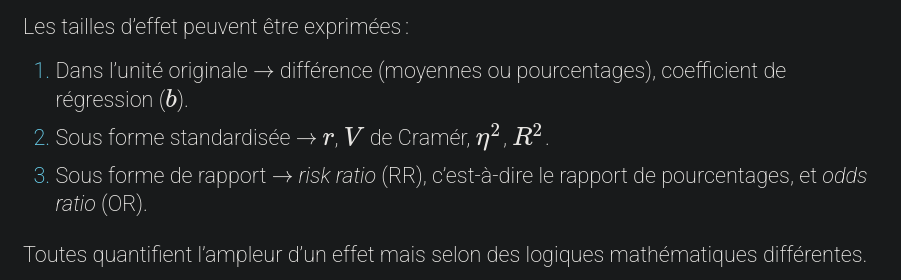
Une taille d’effet quantifie l’ampleur d’un phénomène observé. Selon l’analyse, elle peut mesurer :
- un écart entre groupes.
- la force d’une association.
- la part de la variation de la VD expliquée.
Elle complète la valeur p et permet une interprétation substantielle.
Types de tailles d’effet
Interpréter une taille d’effet
L’importance d’un effet dépend :
- du contexte théorique (attentes issues de la littérature, mécanismes supposés).
- des enjeux pratiques (conséquences humaines, sociales ou politiques).
- des études antérieures et comparaisons possibles.
Un effet faible peut être crucial : une petite baisse de la probabilité d’une guerre compte, vu ce qu’une guerre coûte. → L’interprétation est toujours contextuelle.
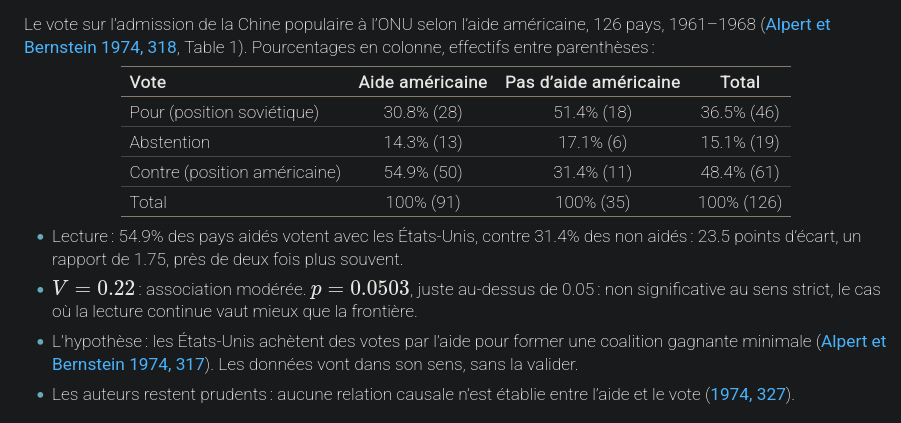
Un exemple complet : l’aide américaine et le vote à l’ONU
Le tableau de moyennes
Comparaison de moyennes
Structure des données
- VD : numérique (échelle d’intervalle ou de ratio).
- VI : catégorielle (nominale ou ordinale) → définit les groupes.
Objectif : comparer les moyennes d’une variable numérique entre différents groupes.
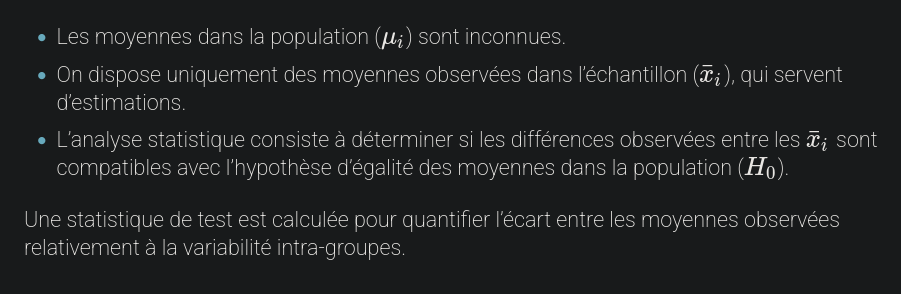
Question générale : les groupes se distinguent-ils sur la variable numérique ou les différences observées sont-elles compatibles avec l’hypothèse d’égalité des moyennes ?
Comparaison de moyennes : principe d’inférence
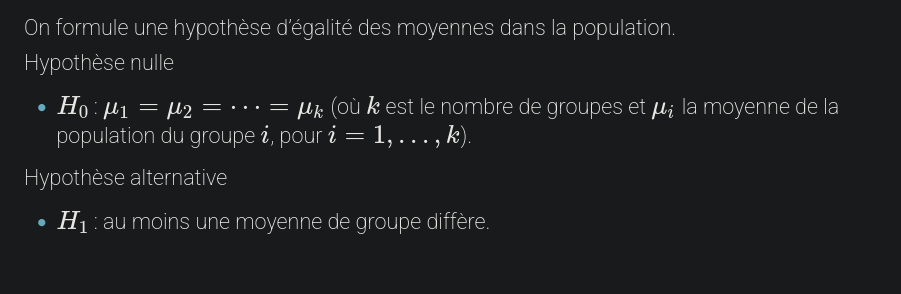
Comparaison de moyennes : hypothèses statistiques
Comparaison de moyennes : deux groupes ou plus
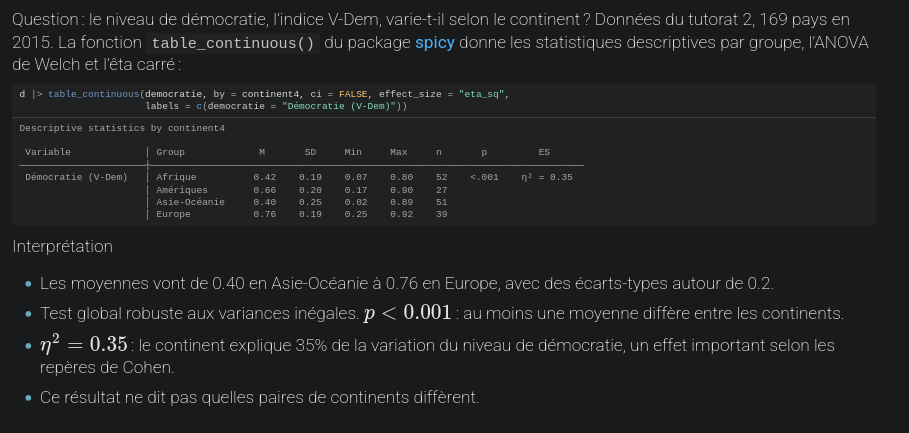
Question : le niveau de démocratie varie-t-il selon le continent (Afrique, Amériques, Asie-Océanie, Europe) ?
Avec deux groupes, on utilise un test t, qui compare les deux moyennes.
Avec plus de deux groupes, on utilise l’analyse de variance (ANOVA à un facteur ou One-way ANOVA) : un test global, qui compare toutes les moyennes à la fois.
- Comparer quatre groupes deux à deux demanderait six tests t, et chaque test ajoute un risque de conclure à tort à une différence : avec six tests, environ 26% (1−0.95⁶=0.265) au lieu de 5%.
- L’ANOVA contrôle ce risque à 5% en un seul test.
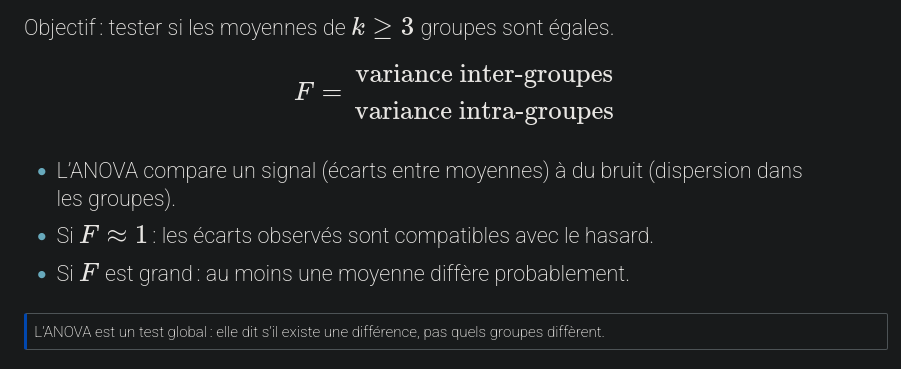
ANalysis Of VAriance : principes
ANOVA : présupposés
Pour une ANOVA classique à un facteur :
- VD numérique (intervalle/ratio), analysée par comparaison de moyennes.
- VI catégorielle avec k≥3 groupes indépendants (pas de mesures répétées).
- Indépendance des observations.
- Normalité approximative de la VD dans chaque groupe.
- Homogénéité des variances entre groupes (variances ou écarts-types comparables).
ANOVA : hypothèses du test global
- H0:μ1=μ2=⋯=μk (toutes les moyennes sont égales).
- H1 : au moins une moyenne diffère. La valeur p indique la probabilité d’observer un ratio F au moins aussi grand si toutes les moyennes populationnelles étaient égales (H0).
Quand les données sont la population entière, comme les 169 pays, la lecture est celle du chi-deux : en redistribuant les pays au hasard entre les groupes, obtiendrait-on souvent des moyennes aussi différentes ?
Un résultat significatif indique une différence globale entre groupes, mais ne précise pas quelles paires diffèrent.
ANOVA : choix du test (décision pratique)
Objectif : comparer les moyennes de k≥3 groupes indépendants (pas de mesures répétées).
- L’ANOVA classique suppose des variances comparables d’un groupe à l’autre.
- L’ANOVA de Welch s’en passe : elle reste valable quand les variances sont inégales, surtout si les tailles de groupes le sont aussi.
En cas de doute sur l’homogénéité des variances, privilégier Welch : choix robuste et largement recommandé.
La fonction table_continuous() du package spicy calcule ce test par défaut, d |> table_continuous(variable, by = groupe), avec les statistiques descriptives par groupe et, sur demande, l’êta carré.
ANOVA de Welch : alternative robuste à l’ANOVA classique
Quand l’utiliser :
- Variances inégales entre groupes, surtout si tailles de groupes inégales.
- VD numérique, groupes indépendants (pas de mesures répétées).
Principe :
- Test global des moyennes, comme l’ANOVA classique.
- Pondère les groupes par leur variance (plus robuste aux variances inégales).
ANOVA de Welch : hypothèses et interprétation
Hypothèses
- H0:μ1=μ2=⋯=μk.
- H1 : au moins une moyenne diffère.
Interprétation
- Si p<0.05 : au moins une moyenne diffère entre les groupes.
- Le test reste global : il ne dit pas quelles paires diffèrent.
ANOVA : taille d’effet
Êta carré (η2) et oméga carré (ω2).
- η2 : part de la variation de la VD expliquée par la VI.
- En ANOVA à un facteur, η2 correspond au R2 du modèle.
- ω2 : estimation moins biaisée de la part de la variation expliquée dans la population.
- ω2 corrige la tendance de η2 à surestimer l’effet, surtout dans les petits échantillons.
Seuils indicatifs devant être contextualisés (repères de Cohen 1988, 283‑87) :
- 0.01 → faible.
- 0.06 → modéré.
- 0.14 → important.
ANOVA de Welch : exemple
Le tableau à trois variables
Pourquoi une troisième variable ?
Une association entre VI et VD peut avoir trois origines :
- la VI agit sur la VD.
- la VD agit sur la VI.
- une troisième variable agit sur les deux. La relation est alors fallacieuse : « when two variables appear to be related to each other, but the relationship is actually caused by a third variable » (Lamont 2015, 111).
L’exemple cité par Lamont [111] : une forte corrélation entre le réchauffement climatique et le recul de la piraterie, évidemment fallacieuse. Aucune des deux variables n’agit sur l’autre : chacune suit une même troisième variable, l’industrialisation, qui réchauffe le climat et fait disparaître la piraterie.
La réponse du tableau croisé : introduire la troisième variable, dite variable de contrôle, et regarder si la relation persiste.
Le principe : les tableaux partiels
- Pour tenir constante la variable de contrôle, on divise les observations en groupes selon ses modalités et l’on examine la relation entre la VI et la VD séparément dans chaque groupe.
- Chaque groupe donne un tableau croisé, dit tableau partiel :
- une variable de contrôle à deux modalités donne deux tableaux partiels.
- le tableau total est la relation bivariée, sans la variable de contrôle.
- On compare ensuite la relation dans chaque tableau partiel à la relation du tableau total.
- Chaque tableau partiel est homogène sur la variable de contrôle : on y compare des unités semblables sur ce point, à la manière de l’approche quasi expérimentale.
- Chaque tableau partiel divise les effectifs : les tests y perdent en puissance (avec moins d’observations, une relation réelle a moins de chances d’être statistiquement significative).
Quatre cas de figure
Comparer la relation dans les tableaux partiels à la relation d’ensemble (Agresti et Finlay 2009, 307‑12) :
- Relation maintenue : elle subsiste dans chaque tableau partiel, avec la même force. La variable de contrôle n’explique pas l’association.
- Relation fallacieuse : elle disparaît dans chaque tableau partiel. L’association d’ensemble venait de la variable de contrôle, liée à la fois à la VI et à la VD.
- La relation disparaît aussi dans une chaîne causale, quand la variable de contrôle est une variable intermédiaire entre la VI et la VD. Les tableaux ne distinguent pas les deux cas : c’est la théorie, par l’ordre temporel des variables, qui tranche.
- Relation masquée : absente du tableau total, elle apparaît dans les tableaux partiels. La variable de contrôle, dite dissimulatrice, cachait l’association entre la VI et la VD.
- Relation spécifiée ou interaction : elle change de force, voire de direction, d’un tableau partiel à l’autre. L’effet de la VI dépend de la variable de contrôle.
Un seul contrôle ne prouve rien : il n’écarte qu’une explication alternative. La régression multiple, au chapitre 5, en introduit plusieurs simultanément.
Exemple : la paix démocratique, le tableau total
Exemple : la paix démocratique, les tableaux partiels
Exemple : la paix démocratique, une relation spécifiée
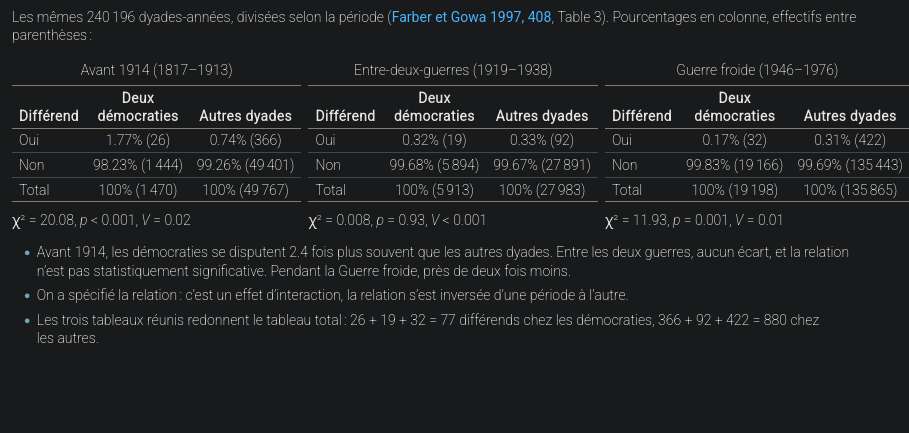
- Le tableau total cachait ce renversement : la Guerre froide ne couvre qu’un cinquième des années étudiées, mais, le nombre d’États ayant explosé après 1945, elle fournit près des deux tiers des dyades-années (Farber et Gowa 1997, 399) et domine le total.
- L’interprétation des auteurs : la période résume la structure des intérêts, les alliances et les intérêts communs que la Guerre froide a créés entre démocraties occidentales [409-410]. « A polity-based hypothesis cannot explain this reversal; the interest-based explanation does so » [414-415].
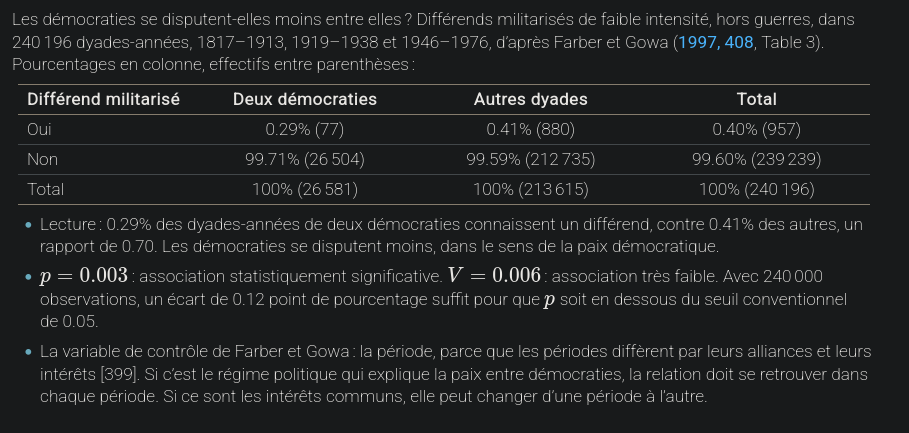
- Dans chaque tableau, V reste minuscule, parce que l’événement est rare : presque toutes les dyades-années sont sans différend. Et avec des centaines de milliers d’observations, le plus petit écart est statistiquement significatif.
- Les données couvrent toutes les paires d’États, la population entière. La valeur p répond donc à la question vue plus haut : en redistribuant au hasard les différends entre les deux types de dyades, obtiendrait-on souvent un écart aussi grand ? Ce qui compte ici, c’est le sens de la relation et son renversement.
- Farber et Gowa ne s’arrêtent pas à ce seul contrôle : ils ajoutent ensuite la contiguïté et le statut de grande puissance dans des modèles multivariés [408].
Un tableau croisé permet-il une inférence causale ?
- Non. Il établit une association.
- Une variable de contrôle écarte une explication alternative.
- Problème de la variable omise : il n’écarte pas les explications dont la variable n’a pas été mesurée ou n’a pas été introduite dans le tableau.
- L’introduction d’une variable de contrôle peut renverser la lecture de la relation bivariée.
- La suite du cours multiplie les contrôles, régression linéaire et logistique, puis revient sur ce que même les contrôles ne règlent pas.
Ce qu’il faut retenir
- L’unité d’observation et le codage fabriquent les données : les repérer en premier.
- Le niveau de mesure est une propriété de la variable. Il détermine la statistique, le test et le modèle. Le traitement reste un choix à justifier.
- Le tableau croisé : pourcentages dans les modalités de la VI, comparer, tester avec le chi-deux, mesurer l’intensité avec le V de Cramér, puis distinguer significativité et importance.
- Le tableau de moyennes : comparer les moyennes d’une variable numérique entre les groupes d’une variable catégorielle, tester avec l’ANOVA de Welch, mesurer l’intensité avec l’êta carré.
- La troisième variable : construire les tableaux partiels, puis comparer. Quatre cas de figure : relation maintenue, fallacieuse, masquée ou spécifiée.
- La lecture causale dépend du dispositif, pas de l’outil : les variables omises restent à traiter.