Qu’est-ce que l’inférence causale?
Ne pas esquiver l’inférence causale
- Le chapitre 2 s’arrête à la frontière de la causalité : Babst la franchit sans le dire et Rai refuse de la franchir.
- King, Keohane et Verba, KKV (1994, 75), observent deux attitudes dans la recherche et les rejettent toutes deux :
- par crainte de confondre corrélation et causalité, s’interdire toute hypothèse causale et présenter son travail comme « studying association and not causation ».
- à l’inverse, présenter comme une « explication » une hypothèse jamais mise à l’épreuve des faits.
- KKV recommandent (p. 76) : oser l’inférence causale à condition d’en détailler l’incertitude.
- Une hypothèse causale mérite le nom d’explication à deux conditions :
- on l’a confrontée à des observations qui pouvaient la contredire et ne l’ont pas contredite.
- on dit à quel point la conclusion est incertaine et ce qui pourrait l’invalider (section 3.2).
- Une explication reste une inférence : on n’observe jamais un lien de cause à effet.
Quatre approches de la causalité
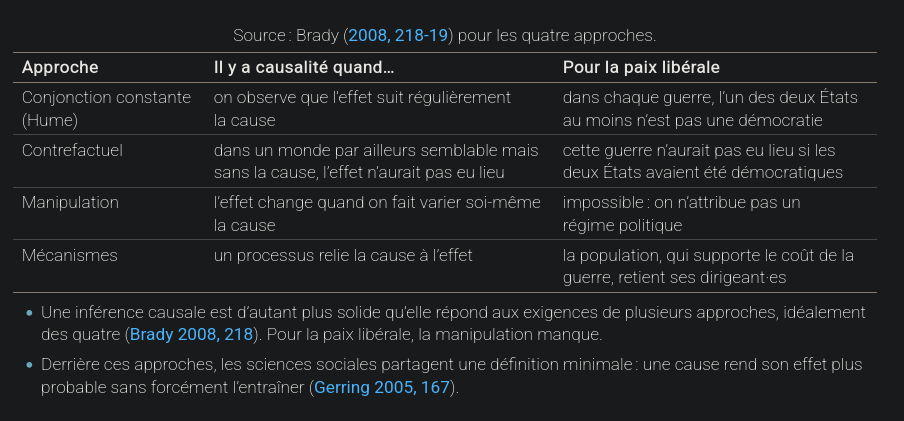
Définir la causalité : le contrefactuel
- KKV s’inscrivent dans la deuxième approche de la causalité : le contrefactuel.
- Ils définissent la causalité par l’effet causal : la différence entre ce que l’on observe avec la cause et ce que l’on aurait observé sans elle, pour la même unité au même moment (King et al. 1994, 77‑78).
- Un effet causal est donc la différence entre deux mondes, dont un seul a eu lieu.
- Théorique et indépendante des données, cette définition vaut pour la recherche qualitative comme quantitative (p. 76).
- Les données servent ensuite à inférer l’effet causal.
L’exemple de KKV : le statut de sortant
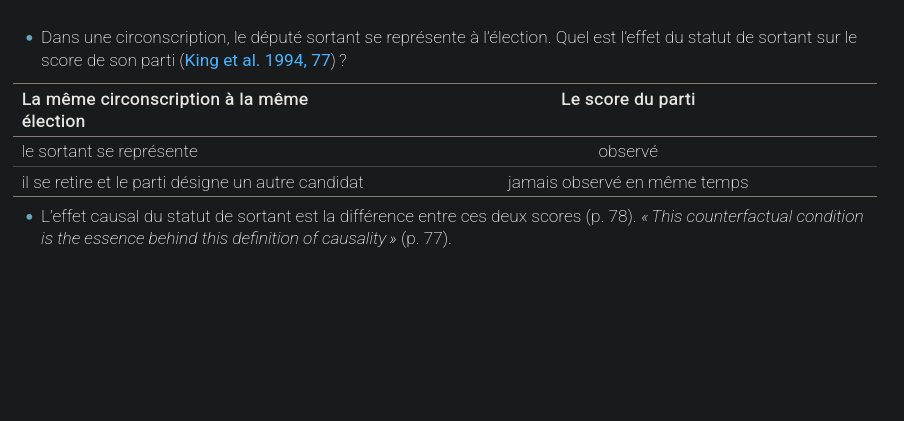
Ce que l’on tient constant et ce que l’on ne contrôle pas
- Le monde sans la cause est imaginé. Il faut donc préciser ce qui y reste constant et ce qui y varie avec la cause (King et al. 1994, 78).
- On tient constant ce qui était déjà fixé quand le parti désigne son candidat : le rapport de force entre les partis, les caractéristiques de la circonscription, le climat économique et politique.
- On laisse varier ce que le statut de sortant apporte au candidat : la notoriété, la visibilité, la connaissance des rouages du Congrès. Ce sont en partie des conséquences de ce statut. Les tenir constantes pourrait conduire à sous‑estimer l’effet du statut de sortant et même à le croire nul (p. 78).
- Contrôler, c’est tenir constant. La règle : on ne contrôle pas les conséquences de la cause. Si deux démocraties commercent davantage parce qu’elles sont des démocraties, tenir le commerce constant efface une part de l’effet du régime.
- Le contrefactuel doit aussi rester plausible : il doit avoir pu se produire dans des circonstances précises (p. 78).
L’effet causal dans nos trois questions
- Paix libérale : l’effet du régime politique est la différence entre ce que l’on observe entre deux États dont l’un au moins n’est pas une démocratie, la guerre ou la paix, et ce que l’on aurait observé entre les mêmes États au même moment s’ils avaient été tous deux démocratiques.
- Maintien de la paix : l’effet d’une mission de l’ONU est la différence entre la durée de la paix avec cette mission et ce qu’aurait été cette durée sans cette mission dans le même pays au même moment.
- Aide au développement : l’effet de l’aide est la différence entre la croissance d’un pays avec cette aide et ce qu’aurait été cette croissance sans cette aide dans le même pays au même moment.
Le problème fondamental de l’inférence causale
« no matter how perfect the research design, no matter how much data we collect, no matter how perceptive the observers, no matter how diligent the research assistants, and no matter how much experimental control we have, we will never know a causal inference for certain. » – King et al. (1994, 79)
- On ne peut pas observer la même unité (une personne, un pays, un conflit) à la fois avec et sans la cause. C’est une propriété du monde (Holland 1986, 947; King et al. 1994, 79).
- Pour la paix libérale : on ne peut pas observer la même paire d’États à la même époque, une fois tous deux démocratiques et une fois non. Pour trancher entre cette théorie et les théories réalistes, pour qui la paix entre démocraties tient à l’ennemi commun soviétique, « il faudrait refaire l’histoire » (Battistella 2006, 520).
Le même problème dans un exemple qualitatif
- Après l’effondrement du système soviétique, les anciennes républiques soviétiques et les pays d’Europe de l’Est se donnent de nouvelles institutions. Régime présidentiel ou régime parlementaire (King et al. 1994, 83) ?
- Pour connaître l’effet du choix de régime sur la stabilité de la démocratie, il faudrait, dans un même pays, instaurer un régime parlementaire, mesurer la stabilité pendant dix ans et, au même moment, instaurer un régime présidentiel, ce qui n’est évidemment pas possible (p. 84).
- Ce pays n’a qu’une seule chance (p. 84).
De l’effet réalisé à l’effet moyen
- L’effet causal défini jusqu’ici est l’effet réalisé : celui d’un seul cas, une seule élection. Il contient une part accidentelle : une gaffe, un débat ou la pluie (King et al. 1994, 78‑79).
- L’effet causal moyen est l’effet typique de la cause : ce qui reste en moyenne une fois ces écarts accidentels annulés (p. 81-82).
- On ne peut pas rejouer la même élection. On approche l’effet moyen en répétant la comparaison sur de nombreux cas, ce qui suppose qu’ils soient comparables.
- L’effet causal lui-même peut varier d’une réplication à l’autre. Un régime présidentiel pourrait réduire la stabilité en moyenne tout en ayant un effet tantôt stabilisateur, tantôt déstabilisateur. Or un pays ne joue qu’une fois : cette variabilité est un risque (p. 82, 84‑85).
Contourner le problème : deux postulats
- On ne peut pas rejouer l’histoire. On compare donc des unités différentes. Selon le nombre de cas, cette comparaison repose sur l’un des deux postulats suivants (King et al. 1994, 91) :
- Pour la comparaison de cas, l’homogénéité des unités (p. 91, 93) :
- on compare deux cas semblables, l’un avec la cause et l’autre sans.
- on postule que le second montre ce que le premier aurait été sans la cause.
- on ne peut pas le prouver : on l’annonce et l’on dit ce qui le rend plausible.
- Pour l’analyse d’un grand nombre de cas, l’indépendance conditionnelle (p. 94) :
- on postule que la cause est attribuée indépendamment du résultat à expliquer.
- l’échantillonnage et l’assignation aléatoires la garantissent (section 3.2). À défaut, il faut savoir quels facteurs décident de l’attribution de la cause et tenir ces facteurs constants dans l’analyse (p. 94-95).
Juger une inférence causale
- Les mêmes critères que pour l’inférence descriptive (King et al. 1994, 97). On imagine l’étude répétée un grand nombre de fois :
- l’absence de biais : viser juste en moyenne.
- l’efficience : varier peu d’une répétition à l’autre.
- L’efficience dépend notamment de la variation de la cause. Tracer d’une main tremblante une droite entre deux points proches donne une pente très incertaine. Entre deux points éloignés, la pente est bien plus sûre (p. 99).
- À l’extrême, une cause qui ne varie pas ne dit rien de son effet (p. 99) : pour Fortna et Howard (2008, 289), n’étudier que les conflits avec mission ne dit rien de ce que la mission ajoute.
L’expérience randomisée comme étalon
- L’expérience dans sa forme la plus pure (Achen 1986, 1) : une population cible, un échantillon aléatoire, puis chaque unité assignée au hasard au groupe « traitement » ou au groupe « contrôle ».
- Cette assignation aléatoire est la randomisation. Elle garantit la comparabilité.
- « randomization guarantees comparability of experimental and control groups, so that a treatment effect may be estimated simply by comparing the outcomes in the two groups » (p. 2).
- les autres facteurs, mesurés ou non, s’équilibrent en moyenne entre les deux groupes (Shadish et al. 2002, 248).
- On peut donc établir un effet causal sans disposer d’une théorie du phénomène étudié.
- « One can learn whether a cancer treatment is effective without understanding the nature of cancer, for example » (Achen 1986, 2).
Deux usages du hasard
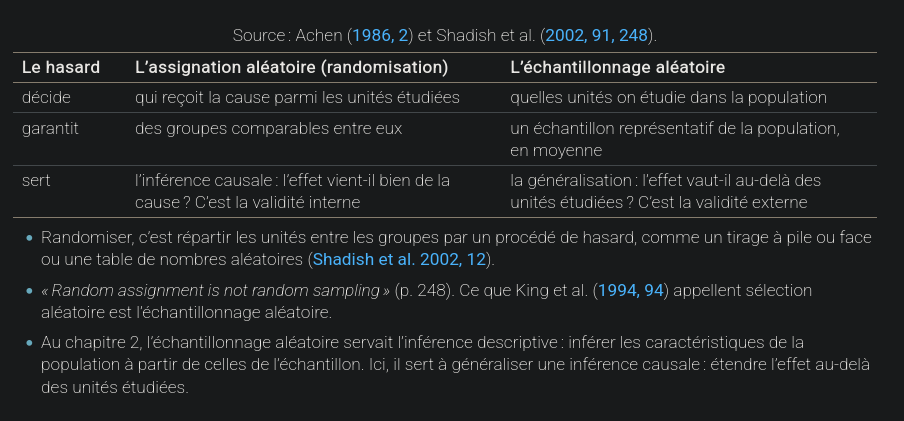
L’expérience sans échantillon aléatoire
« Sampling subjects randomly from a large population is unusual in field experimental research. Typically the subjects are selected through convenience sampling, which is to say no particular sampling method other than the fact that the subjects were close at hand. » – Gerber et Green (2012, 352)
- L’échantillon de convenance réunit les unités que l’on a sous la main. Gerber et Green ont étudié les électrices et les électeurs de New Haven, près de leur université (p. 352).
- Que vaut alors l’expérience ?
- pour Shadish et al. (2002, 12), l’assignation aléatoire suffit : c’est une expérience randomisée. Sa validité externe reste à établir.
- pour Achen (1986, 1, 4), il faut aussi un échantillon aléatoire : ce n’est plus une expérience sur la population cible.
- Un échantillon de convenance ne pose problème que si l’effet causal dépend d’une caractéristique que tout l’échantillon partage (Druckman et Kam 2011, 41). Si l’effet change avec l’âge, des étudiant·es de vingt ans ne disent rien de ce qu’il serait à soixante.
- L’échantillon aléatoire est recommandé mais « so rarely feasible in experiments » (Shadish et al. 2002, 91).
Les obstacles à la randomisation
Quatre obstacles selon Achen (1986, 7‑11) :
- physique : certaines causes ne s’attribuent pas. Achen prend l’effet de la couleur de peau d’un meurtrier sur la décision des jurés (p. 7).
- social : les États choisissent leurs politiques, certains sont gouvernés par les militaires et ces décisions ne dépendent d’aucune équipe de recherche (p. 8). On n’attribue pas un régime politique.
- économique ou politique : l’expérience coûte cher. Les personnes qui appliquent un programme croient à son efficacité et peuvent résister à la randomisation (p. 8-9).
- éthique :
- certaines études sont indéfendables, comme celle où des antibiotiques ont été refusés pendant des décennies à des malades de la syphilis (p. 9).
- même sans maltraitance, le respect du libre choix peut exclure la randomisation : on ne tire au sort ni l’enfant très défavorisé qui recevra un programme d’aide ni le traitement d’une malade du cancer (p. 9-10).
Conséquence : en sciences sociales, la grande majorité des questions intéressantes échappent à la randomisation.
Trois types d’étude
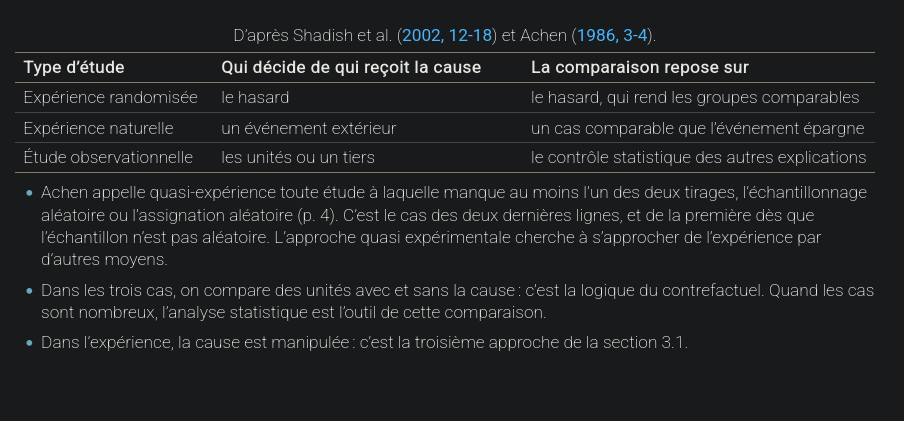
Les deux défauts de la quasi-expérience
« They are all quasi-experiments–that is, something other than a random sample of the relevant population with random assignment to treatment and control groups. » – Achen (1986, 4)
Deux défauts :
- l’assignation non aléatoire (auto-sélection) : qui reçoit la cause ?
- les unités entrent dans les groupes « as a result of personal decisions by the subjects or their proxies » (p. 4).
- les groupes « may be very different indeed, and nothing like the comparable groups that randomization would have produced » (p. 4).
- l’échantillon censuré : quels cas observe-t-on ?
- une université ne connaît la réussite que des personnes qu’elle a admises, choisies justement pour leur réussite probable.
- un sondage tire les personnes au hasard, mais 30 ou 50% refusent de répondre. Celles qui refusent ne forment probablement pas un groupe aléatoire : l’échantillon obtenu n’est plus aléatoire.
L’auto-sélection biaise dans les deux sens
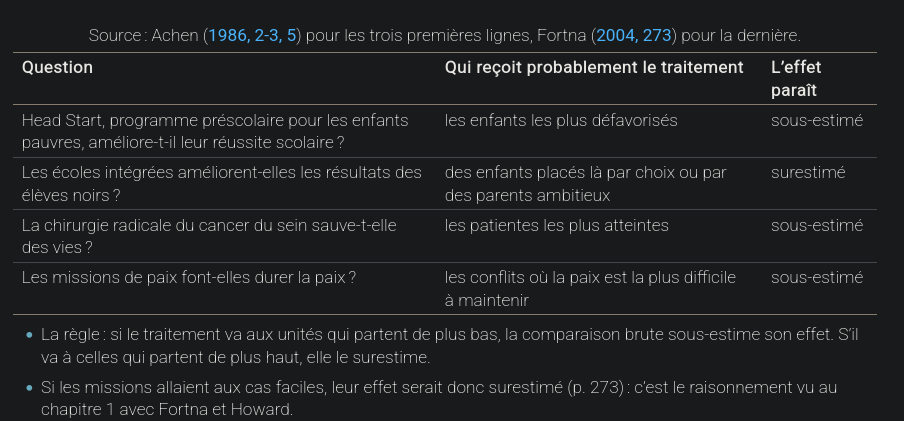
Le contrôle statistique et sa faille
- Faute d’assignation aléatoire, on contrôle : on tient constant ce qui distingue les groupes. Si les patientes les plus atteintes choisissent la chirurgie radicale, on compare à gravité égale (Achen 1986, 12).
- Il n’est pas nécessaire de tout contrôler. Il suffit de bien choisir les facteurs clés pour que ce qui reste hors de l’analyse soit « approximately random, that is, not correlated with the controlled variables or the treatment » (p. 14).
- Mais c’est un postulat et non une garantie : ces facteurs laissés de côté « are assumed to be randomized » (p. 12). Et ce choix est « often the hardest single step in empirical work » (p. 13).
- Les sceptiques vont plus loin :
« The more one needs the ‘controls’ and ‘adjustments’ which these statistics seem to offer, the more biased are their outcomes. » – Campbell et Erlebacher, cités par Achen (1986, 13)